Mixer la voix de ses vidéos YouTube : ma chaîne de traitement
16 octobre 2026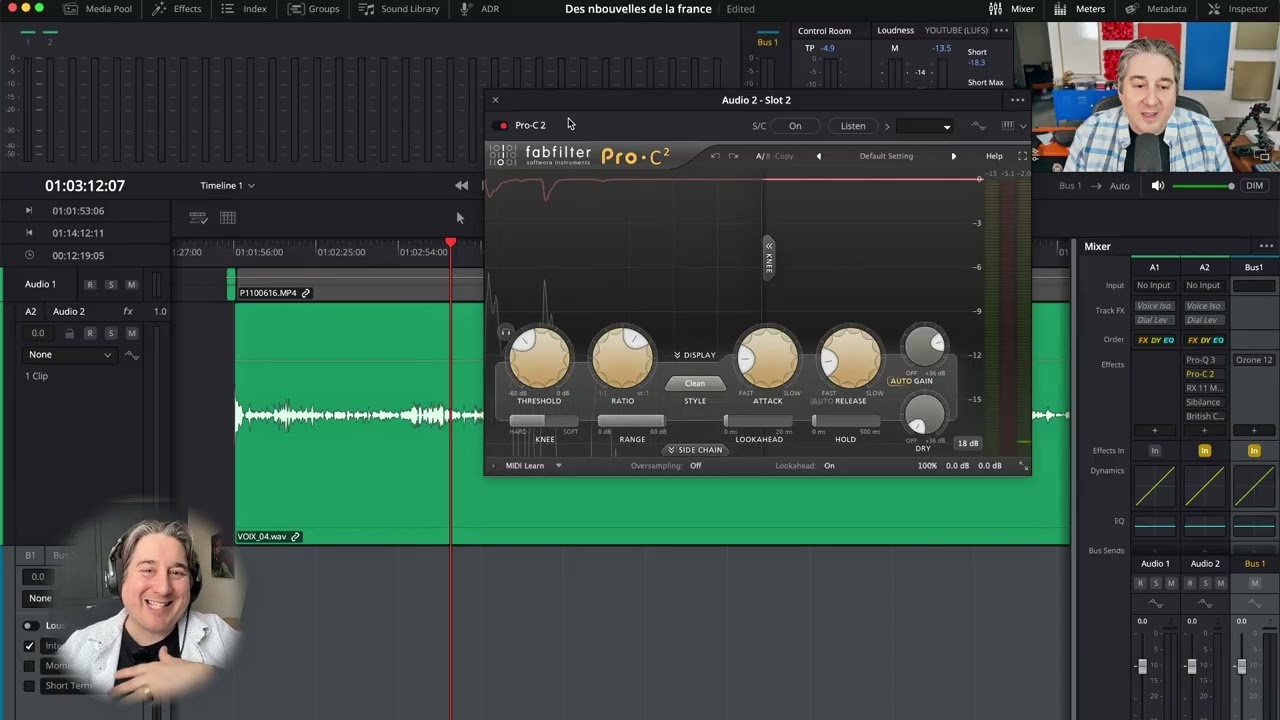
Mixer la voix de ses vidéos YouTube, d'un podcast ou d'une narration ne demande ni studio haut de gamme ni logiciel audio dédié : la section audio de votre logiciel de montage suffit largement. Voici la chaîne de traitement que j'utilise pour ma propre voix, enregistrée avec un SM7B branché directement dans une carte son, puis les particularités à connaître quand on mixe dans un logiciel de montage comme Final Cut Pro. Le fil conducteur : en voix parlée, le confort d'écoute passe avant tout.
Le point de départ : une prise propre, sans traitement
Ma voix est enregistrée avec un Shure SM7B, branché directement dans le préampli de ma carte son (une RME Babyface Pro FS). Pas de matériel analogique entre les deux : c'est très proche de ce que vous avez probablement à la maison. Les seuls réglages actifs à la prise sont ceux du micro lui-même : le petit coupe-bas et le léger boost dans les médiums qu'on peut enclencher à l'arrière du SM7B. Si vous vous demandez si ce micro mérite sa réputation, j'en parle dans Shure SM7B : mythe ou réalité.
J'enregistre avec beaucoup de marge : le niveau est assez bas, pour ne jamais risquer de taper dans le rouge. C'est le compresseur, puis le limiteur, qui remonteront le volume.
Je fais le mix directement dans DaVinci Resolve, mon logiciel de montage. Sa section audio est très bien faite et offre largement assez de fonctions pour un mix de voix qui tient la route : une piste mono pour la voix, éventuellement une piste stéréo pour l'intro, et un bus qui joue le rôle de piste master.
1. L'égalisation : nettoyer avant de compresser
L'EQ vient en premier dans la chaîne, parce qu'on veut retirer l'information inutile avant qu'elle n'arrive au compresseur. Mes réglages sur cette voix :
- Coupe-bas à 100 Hz, pente de 24 dB par octave : plus agressif que pour une voix chantée. En voix parlée, je veux vraiment nettoyer le grave et être certain de ne pas avoir de plosives.
- Une atténuation entre 800 et 1000 Hz : c'est à mon avis le réglage le plus important. Ça retire un peu d'agressivité et adoucit la voix.
- Environ -1 dB vers 400 Hz, pour alléger un peu les bas-médiums.
- +1,3 dB vers 3000 Hz et +1 dB en shelf à 10 kHz, à très petite dose.
On évite de trop booster les aigus sur une voix parlée : elle n'a pas besoin d'être ultra brillante, et trop d'aigu devient vite fatigant à écouter pendant une vidéo de quinze minutes.
2. La compression : contrôler sans écraser
J'utilise le Pro-C 2 de FabFilter avec un ratio de 4:1, un knee au milieu, une attaque de 1,7 ms et un release de 43 ms. Le but est de viser 3 à 6 dB de réduction maximum sur les passages les plus forts. Sur les passages calmes, le compresseur ne travaille presque pas, et c'est voulu.
Pourquoi ne pas compresser davantage ? Parce qu'une compression trop forte fait remonter tout ce qu'on ne veut pas entendre : les bruits de bouche, la résonance de la pièce et le bruit de fond. Si vous partez d'un preset, celui nommé « Clean » me semble souvent plus juste que le preset « Vocal », que je trouve un peu trop appuyé.
3. Bruits de bouche et sibilances
Viennent ensuite deux traitements de confort :
- Un de-click pour la bouche (Mouth De-click de la suite RX d'iZotope) : il retire les petits claquements de bouche qui apparaissent quand on a oublié de boire un verre d'eau. Avec un SM7B, c'est subtil, presque inaudible. Avec un micro à condensateur ou un micro-cravate, ces bruits sont souvent plus présents et l'outil devient plus utile.
- Un de-esser : le SM7B n'est pas particulièrement agressif dans les « s », mais sur un téléphone ou un petit système avec peu de grave, les sibilances ressortent davantage. Quelques dB d'atténuation suffisent. Si on pousse trop, on obtient l'effet « cheveu sur la langue ». Tous les détails dans mon article sur le de-esser et les sibilances.
4. Une touche de saturation pour la présence
D'habitude, j'enregistre ma voix à travers un préampli Great River, un EQ de type API et un compresseur Distressor, qui ajoutent une coloration harmonique. Ici, rien de tout ça : le préampli de la carte son est propre, fidèle, mais n'apporte presque aucune couleur. Je compense avec une saturation de Softube qui émule les préamplis de type Neve.
N'importe quelle saturation douce, de type lampe ou bande, fera l'affaire, y compris des plugins gratuits. Ce n'est pas le jour et la nuit, mais ça rouvre la voix, ça lui donne du mordant et de la présence, et ça enlève ce côté un peu terne des voix qui ne sont passées par aucune coloration analogique.
5. Le limiteur et le volume final
Sur le bus master, je place toujours un limiteur. Il attrape les derniers pics que le compresseur n'a pas contrôlés et permet de remonter un peu le niveau de sortie. Je ne veux pas qu'il travaille en permanence : c'est une sécurité, pas un traitement dynamique. Il devient plus actif quand je mélange de la musique avec la voix.
- Plafond (output) : vers -1 ou -1,5 dB, pour laisser de la marge aux conversions de YouTube.
- Volume : inutile de dépasser -14 LUFS, le niveau de normalisation de YouTube. Si vous êtes plus fort, la plateforme baissera le volume de toute façon. Pour comprendre ces mesures, voyez LUFS et LKFS expliqués.
Mixer dans Final Cut Pro : les pièges à connaître
Dans cette vidéo plus ancienne, je mixe une voix off dans Final Cut Pro, enregistrée à l'époque avec un micro-cravate DPA omnidirectionnel branché dans un enregistreur portable Tascam. La démarche est la même, avec quelques nuances.
Chercher la résonance propre à votre prise
Un micro omnidirectionnel capte beaucoup les réflexions de la table et de l'écran. Sur ma voix, ça créait une résonance vers 400 Hz que j'ai atténuée avec une cloche assez fine (environ -8 dB), plus une petite coupe vers 700 Hz. Pour trouver la vôtre : faites un boost étroit, balayez jusqu'à trouver la zone où la voix sonne voilée, fermée, puis atténuez-la. Évitez de dépasser 10 dB d'atténuation : nettoyer trop crée de nouveaux problèmes. J'ai aussi adouci le haut du spectre vers 10 kHz, où ce type de micro ajoute souffle et dureté. Et attention aux boosts dans le grave sur un micro-cravate : la voix devient vite étrange, boomy.
Une compression rapide, ou deux compresseurs légers
Avec l'alpha compressor d'elysia : release automatique, attaque et release rapides, ratio de 4:1 ou 5:1, pour attraper seulement les pics importants. Si vous voulez contrôler davantage, mettez plutôt deux compresseurs à la suite qui travaillent chacun un peu : c'est plus transparent qu'un seul qui écrase.
Le piège du fichier stéréo « dual mono »
Si votre enregistreur génère un fichier stéréo avec la voix d'un seul côté, réglez la piste en dual mono dans Final Cut et désactivez le canal vide. Sachez alors que la voix paraîtra environ 6 dB plus basse qu'attendu : il faut remonter le fader en conséquence. Je vous conseille de le monter d'environ 4 dB seulement, ou de régler le plafond du limiteur à -2 dB, pour garder 2 dB de marge avant l'export en AAC et la recompression de YouTube. Une piste mono n'a pas ce problème.
Le résumé : en faire moins que trop
Pour une voix parlée, concentrez-vous sur deux choses : le nettoyage (grave et médiums) et le contrôle de la dynamique. Plus vous poussez les traitements, plus vous mettez en valeur les défauts de la prise. Une voix trop intense nuit à l'image au lieu de l'appuyer. Si votre micro est un modèle cravate abordable, mon article sur le mix d'une voix enregistrée avec un micro-cravate pas cher complète celui-ci.
Et si vous voulez maîtriser l'EQ et la compression pour toutes vos voix, parlées comme chantées, ma formation MIX 101 reprend ces outils depuis la base.
À lire aussi
Pour aller plus loin
MIX VOIX ROCK
EQ, compression, effets : traiter une voix pour qu'elle reste claire et devant, du début à la fin du morceau.
Découvrir la formation →Gratuit
2 guides PDF + la formation EQ 101
Inscrivez-vous à l’infolettre et recevez mes guides d’égalisation et de compression, deux sessions multipistes et un accès à la formation vidéo EQ 101 (3 h 31).
Un courriel de temps en temps. Désinscription en un clic.